Alertas e on-call
LidoEsta aula aborda a criação de alertas eficazes em DevOps, focando em alertas acionáveis, prevenção de fadiga de alertas, estratégias de escalonamento e uso de runbooks. Inclui exemplos práticos com Prometheus e Alertmanager, boas práticas e exercícios com respostas.
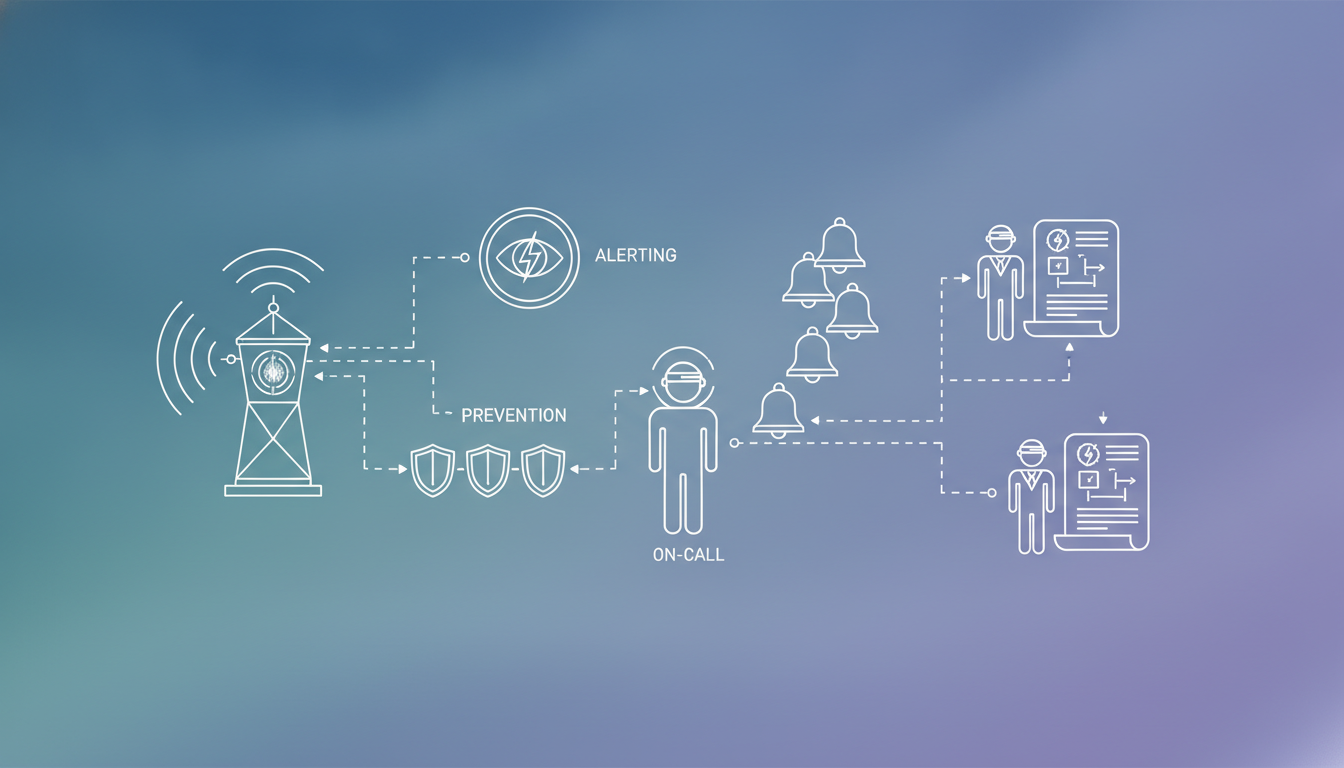
Alertas e on-call são componentes críticos em qualquer operação de DevOps. Quando um sistema falha, a capacidade de detectar, notificar e responder rapidamente é essencial para minimizar o impacto. Nesta aula, exploraremos como projetar alertas eficazes, evitar a fadiga de alertas, implementar escalonamento e criar runbooks que orientem os engenheiros durante incidentes.
Vamos mergulhar nos conceitos e práticas que transformam alertas de meras notificações em ferramentas de ação. Você aprenderá a diferenciar alertas acionáveis de ruído, a configurar escalonamento inteligente e a documentar procedimentos de resposta.
Alertas acionáveis
Um alerta acionável é aquele que exige uma ação específica de um humano ou sistema. Ele deve ser claro, conciso e conter informações suficientes para que o responsável saiba exatamente o que está acontecendo e o que fazer a seguir. Alertas vagos ou sem contexto levam a atrasos na resposta e aumentam a frustração da equipe.
Para criar alertas acionáveis, pergunte-se: "Se eu receber este alerta, saberei o que fazer?" Um alerta eficaz deve incluir: o serviço afetado, a métrica que disparou, o valor atual e o limite, o impacto esperado e possíveis ações de mitigação. Por exemplo, em vez de "CPU alta", use "CPU do servidor web-01 acima de 90% por 5 minutos, causando lentidão no site. Reinicie o serviço nginx ou escale horizontalmente."
# Exemplo de regra de alerta no Prometheus (alert.rules.yml)
groups:
  - name: example
    rules:
      - alert: HighCpuUsage
        expr: 100 - (avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 90
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "CPU alta em {{ $labels.instance }}"
          description: "O servidor {{ $labels.instance }} está com CPU acima de 90% por mais de 5 minutos."
          runbook: "https://wiki.exemplo.com/runbooks/high-cpu"
No exemplo acima, o alerta especifica a métrica, o limite, a duração e inclui um link para o runbook. Isso permite que o engenheiro de plantão aja rapidamente, sem precisar investigar o que fazer.
Fadiga de alertas
Fadiga de alertas ocorre quando os engenheiros recebem tantos alertas que começam a ignorá-los ou a perder a sensibilidade. Isso é perigoso, pois alertas críticos podem ser perdidos em meio a ruído. A fadiga de alertas é causada por alertas excessivos, mal calibrados ou sem ação.
Para evitar a fadiga, é fundamental reduzir o ruído: ajuste limites, aumente a duração (for) para evitar picos transitórios, e desative alertas que não geram ação. Além disso, use agrupamento de alertas para consolidar notificações relacionadas. Ferramentas como Alertmanager permitem agrupar alertas por serviço ou severidade, reduzindo o número de mensagens.
# Configuração do Alertmanager para agrupar alertas (alertmanager.yml)
route:
  group_by: ['alertname', 'service']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  receiver: 'team-x'
receivers:
  - name: 'team-x'
    email_configs:
      - to: 'team-x@exemplo.com'
Neste exemplo, alertas com o mesmo nome e serviço são agrupados, e a repetição é limitada a cada 4 horas. Isso evita que a equipe receba dezenas de e-mails para o mesmo problema. Além disso, é importante revisar periodicamente os alertas e remover aqueles que não são mais relevantes.
Escalonamento
Escalonamento é o processo de garantir que um alerta seja tratado pelo nível adequado de responsabilidade, caso não seja resolvido em um tempo determinado. Isso envolve definir uma hierarquia de pessoas ou equipes e regras de escalonamento baseadas em tempo, severidade ou ausência de resposta.
Um sistema de escalonamento típico começa com o engenheiro de plantão primário. Se ele não reconhecer o alerta dentro de X minutos, o alerta é escalado para o secundário, depois para o gerente, e assim por diante. Ferramentas como PagerDuty, Opsgenie ou o próprio Alertmanager podem configurar políticas de escalonamento.
# Exemplo de política de escalonamento no Alertmanager (alertmanager.yml)
route:
  receiver: 'primary'
  group_by: ['alertname']
  routes:
    - match:
        severity: critical
      receiver: 'primary'
      continue: true
    - match:
        severity: critical
      receiver: 'secondary'
      continue: true
receivers:
  - name: 'primary'
    webhook_configs:
      - url: 'https://hooks.exemplo.com/primary'
  - name: 'secondary'
    webhook_configs:
      - url: 'https://hooks.exemplo.com/secondary'
Neste exemplo, alertas críticos primeiro vão para o receptor primário e, se não forem resolvidos, o Alertmanager (com configuração adicional) pode encaminhar para o secundário. Na prática, você usaria uma ferramenta de gerenciamento de incidentes para controlar o tempo e o reconhecimento.
É essencial documentar a política de escalonamento e comunicá-la à equipe. Todos devem saber quem é o responsável em cada horário e como acionar o próximo nível.
Runbooks
Runbooks são documentos que descrevem procedimentos passo a passo para lidar com incidentes ou tarefas operacionais. Eles são essenciais para que qualquer pessoa, mesmo sem experiência prévia, possa responder a um alerta de forma consistente e eficaz. Um bom runbook reduz o tempo de resolução e evita erros.
Um runbook deve conter: descrição do problema, impacto, sintomas, passos de diagnóstico, ações de mitigação, comandos úteis, e contatos de suporte. Deve ser fácil de acessar, atualizado regularmente e testado. Ferramentas como Confluence, GitHub ou até mesmo um wiki simples podem hospedar runbooks.
# Exemplo de runbook para CPU alta (runbook-high-cpu.md)
# Runbook: CPU Alta

## Descrição
O servidor está com uso de CPU acima de 90% por mais de 5 minutos.

## Impacto
Lentidão no serviço, possíveis timeouts.

## Sintomas
- Alertas de CPU alta
- Usuários reclamam de lentidão

## Diagnóstico
1. Acesse o servidor via SSH.
2. Execute `top` para ver os processos.
3. Verifique se há processos anormais: `ps aux --sort=-%cpu | head`.

## Mitigação
- Reinicie o serviço principal: `systemctl restart nginx`.
- Se persistir, escale horizontalmente adicionando mais instâncias.
- Se for um processo específico, mate-o: `kill -9 PID`.

## Comandos úteis
- `uptime`
- `htop`
- `iostat`

## Contatos
- Suporte: #infra no Slack
- Gerente: João (joao@exemplo.com)
Runbooks devem ser versionados e revisados após cada incidente para incorporar aprendizados. Eles são uma fonte de verdade para a equipe e ajudam a padronizar as respostas.
Boas práticas e observações finais
Algumas boas práticas adicionais: comece com alertas simples e evolua; use alertas baseados em SLOs (Service Level Objectives) para focar no que importa; automatize a criação de runbooks a partir de alertas; e treine a equipe regularmente com simulações de incidentes. Lembre-se de que o objetivo dos alertas é permitir uma resposta rápida, não gerar ruído.
Referências
- Prometheus Alerting Overview
- What is Alert Fatigue? - PagerDuty
- Grafana Alerting Documentation
- Google Cloud: Incident Response and Runbooks
- 5 Steps to Create Effective Runbooks - Medium
- Atlassian: Runbook Best Practices
- Alert Fatigue: How to Avoid It - DevOps.com
Exercícios
- Escreva uma regra de alerta no Prometheus que detecte quando o uso de memória de um servidor exceder 85% por 10 minutos. Inclua labels e annotations com descrição e runbook.
- Explique como o agrupamento de alertas no Alertmanager pode reduzir a fadiga de alertas e dê um exemplo de configuração.
- Descreva um cenário de escalonamento em três níveis e como você implementaria isso com uma ferramenta como PagerDuty.
- Crie um runbook para um alerta de disco cheio (usage > 90%). Inclua diagnóstico e ações.
- Quais são as principais causas de fadiga de alertas e como evitá-las? Cite pelo menos três estratégias.
groups:
  - name: memory
    rules:
      - alert: HighMemoryUsage
        expr: (1 - (node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes)) * 100 > 85
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Memória alta em {{ $labels.instance }}"
          description: "O servidor {{ $labels.instance }} está com uso de memória acima de 85% por mais de 10 minutos."
runbook: "https://wiki.exemplo.com/runbooks/high-memory"route:
group_by: ['alertname', 'service']
group_wait: 30s
group_interval: 5m
repeat_interval: 4h# Runbook: Disco cheio
## Descrição
O uso do disco excedeu 90%.
## Impacto
Falha em gravações, possível corrupção de dados.
## Sintomas
- Alertas de uso do disco
- Erros de escrita
## Diagnóstico
1. Execute `df -h` para ver o uso.
2. Identifique os maiores arquivos: `du -h / | sort -h | tail`.
3. Verifique logs que crescem: `journalctl --disk-usage`.
## Mitigação
- Limpe logs antigos: `journalctl --vacuum-time=2d`.
- Remova arquivos temporários: `rm -rf /tmp/*`.
- Aumente o disco (se for VM).
- Mova dados para outro volume.
## Comandos úteis
- `df -h`
- `du -sh *`
- `lsof +L1`
## Contatos
- Suporte: #infra
- Sysadmin: Maria (maria@exemplo.com)Continue lendo
Mais artigos de DevOps para seguir daqui.
Métricas e monitoramento
Esta aula apresenta os fundamentos de métricas e monitoramento em DevOps, com foco no Prometheus. Você aprenderá os tipos de métricas, como criar alertas eficazes e construir dashboards para visualizar o estado dos seus sistemas.
Lido
Site Reliability Engineering (SRE)
Esta aula apresenta o conceito de Site Reliability Engineering (SRE), sua origem no Google, os princípios fundamentais e como ele se relaciona com DevOps. O aluno aprenderá a importância da confiabilidade em sistemas de software e como aplicar práticas de SRE no dia a dia.
Lido
Dashboards e visualização
Nesta aula, você aprenderá a criar dashboards eficazes para monitoramento de DevOps, com foco em Grafana, seleção de métricas relevantes, dashboards acionáveis e boas práticas de visualização.
Lido