Projeto: stack de observabilidade
LidoNesta aula, você vai construir uma stack de observabilidade completa para um projeto DevOps, cobrindo métricas, logs, dashboards e alertas. Vamos usar ferramentas open source como Prometheus, Grafana, Loki e Alertmanager, com exemplos práticos de configuração e integração.
Nesta aula, vamos colocar em prática os conceitos de observabilidade, construindo uma stack completa para monitorar uma aplicação. Você aprenderá a coletar métricas, centralizar logs, criar dashboards interativos e configurar alertas eficientes. Essa é uma habilidade essencial para qualquer profissional de DevOps, pois garante que seus sistemas sejam confiáveis e que problemas sejam detectados e resolvidos rapidamente.
Vamos utilizar um conjunto de ferramentas open source amplamente adotadas no mercado: Prometheus para métricas, Loki para logs, Grafana para visualização e Alertmanager para alertas. Ao final, você terá uma base sólida para implementar observabilidade em seus próprios projetos.
Métricas
Métricas são medições numéricas que descrevem o estado de um sistema em um determinado momento. Elas são essenciais para entender o comportamento da aplicação, como taxa de requisições, uso de CPU, memória, latência, etc. No contexto DevOps, as métricas são coletadas de forma contínua e armazenadas em um banco de dados de séries temporais, como o Prometheus.
O Prometheus coleta métricas por meio de endpoints HTTP que expõem dados no formato de texto. A aplicação precisa ser instrumentada para expor essas métricas, ou podemos usar exporters prontos, como o node_exporter para métricas do sistema operacional.
Vamos configurar o Prometheus para coletar métricas de uma aplicação de exemplo. Primeiro, precisamos definir o arquivo de configuração do Prometheus (prometheus.yml):
global:
  scrape_interval: 15s

scrape_configs:
  - job_name: 'node'
    static_configs:
      - targets: ['localhost:9100']
  - job_name: 'app'
    static_configs:
      - targets: ['localhost:8080']
Neste arquivo, definimos que o Prometheus deve coletar métricas a cada 15 segundos de dois alvos: o node_exporter (porta 9100) e nossa aplicação (porta 8080). Para que a aplicação exponha métricas, podemos usar uma biblioteca como a prometheus-client para Python, ou um middleware para Node.js, por exemplo.
Com o Prometheus rodando, podemos consultar as métricas usando a linguagem PromQL. Por exemplo, para ver o uso de CPU de todos os nós:
rate(node_cpu_seconds_total{mode="idle"}[5m])Isso retorna a taxa de segundos de CPU em modo idle nos últimos 5 minutos. Com essas métricas, podemos criar alertas e dashboards.
Logs
Logs são registros de eventos que ocorrem em um sistema, como erros, avisos e informações de depuração. Eles são fundamentais para investigar problemas e entender o que aconteceu em um determinado momento. Em uma stack de observabilidade, os logs são centralizados para facilitar a busca e correlação com métricas.
O Loki é um sistema de agregação de logs projetado para ser eficiente e de baixo custo, integrando-se bem com o Grafana. Ele indexa apenas os metadados (labels) e o conteúdo é armazenado de forma compacta. Para enviar logs para o Loki, usamos um agente como o Promtail, que coleta logs de arquivos e os envia.
Vamos configurar o Promtail para coletar logs de uma aplicação. O arquivo de configuração promtail.yml pode ser assim:
server:
  http_listen_port: 9080
  grpc_listen_port: 0

positions:
  filename: /tmp/positions.yaml

clients:
  - url: http://localhost:3100/loki/api/v1/push

scrape_configs:
  - job_name: app
    static_configs:
      - targets:
          - localhost
        labels:
          job: app
          __path__: /var/log/app/*.log
Nesse exemplo, o Promtail monitora os arquivos em /var/log/app/ e envia os logs para o Loki na porta 3100. No Grafana, podemos explorar esses logs usando a linguagem LogQL, semelhante ao PromQL. Por exemplo, para buscar erros na aplicação:
{job="app"} |= "ERROR"Isso retorna todas as linhas de log da aplicação que contêm a palavra ERROR. Com isso, podemos criar painéis de logs e correlacionar com métricas.
Dashboards
Dashboards são painéis visuais que consolidam métricas e logs em gráficos, tabelas e outros elementos, permitindo uma visão rápida do estado do sistema. O Grafana é a ferramenta mais popular para criar dashboards, pois se integra com Prometheus, Loki e muitas outras fontes de dados.
Para criar um dashboard, precisamos adicionar as fontes de dados no Grafana (Prometheus e Loki). Depois, podemos criar painéis com consultas em PromQL ou LogQL. Por exemplo, um gráfico de linha mostrando a taxa de requisições HTTP da aplicação:
rate(http_requests_total[5m])E um painel de logs mostrando os erros mais recentes:
{job="app"} |= "ERROR"O Grafana permite personalizar o layout, adicionar alertas e compartilhar dashboards. Um bom dashboard deve ser claro, objetivo e mostrar apenas informações relevantes. Podemos usar variáveis para criar dashboards dinâmicos, como selecionar o ambiente (produção, homologação).
Vamos ver um exemplo de configuração de um dashboard simples em JSON, que pode ser importado no Grafana. Esse dashboard terá um painel de métricas e um de logs:
{
  "dashboard": {
    "title": "Meu Dashboard",
    "panels": [
      {
        "title": "Taxa de Requisições",
        "type": "graph",
        "targets": [
          {
            "expr": "rate(http_requests_total[5m])",
            "legendFormat": "{{method}}"
          }
        ]
      },
      {
        "title": "Logs de Erro",
        "type": "logs",
        "targets": [
          {
            "expr": "{job=\"app\"} |= \"ERROR\"",
            "refId": "A"
          }
        ]
      }
    ]
  }
}
Essa configuração pode ser salva como um arquivo JSON e importada no Grafana via API ou interface web.
Alertas
Alertas são notificações automáticas que informam quando uma condição anormal é detectada, como alta latência ou erro em massa. Eles são essenciais para que a equipe possa agir rapidamente antes que o problema afete os usuários. Na stack de observabilidade, o Alertmanager é responsável por gerenciar os alertas gerados pelo Prometheus.
Para criar alertas, definimos regras no Prometheus que avaliam expressões PromQL e disparam quando a condição é verdadeira por um determinado período. Vamos criar um arquivo de regras alerts.yml:
groups:
  - name: example
    rules:
      - alert: HighErrorRate
        expr: job:app_errors:rate5m > 0.05
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "High error rate detected"
          description: "Error rate is above 5% for more than 5 minutes."
Aqui, definimos um alerta que dispara se a taxa de erros da aplicação for maior que 5% por 5 minutos. As anotações fornecem informações adicionais, e o label severity pode ser usado para priorizar.
O Alertmanager recebe esses alertas e pode enviá-los para diferentes canais, como e-mail, Slack, PagerDuty, etc. A configuração do Alertmanager (alertmanager.yml) pode ser assim:
route:
  receiver: 'default'
receivers:
  - name: 'default'
    email_configs:
      - to: 'devops@example.com'
    slack_configs:
      - channel: '#alerts'
        send_resolved: true
Com isso, quando um alerta é disparado, a equipe recebe uma notificação no e-mail e no Slack. É importante definir boas regras de alerta para evitar falsos positivos e ruído.
Referências
- Prometheus Overview
- Grafana Documentation
- Loki Documentation
- Alertmanager Documentation
- PromQL Basics
- Grafana Dashboards
Exercícios
Configure o Prometheus para coletar métricas de um serviço local (por exemplo, use o node_exporter). Escreva o arquivo
prometheus.ymle explique como você verificaria se a coleta está funcionando.✓ Resposta: O arquivoprometheus.ymldeve conter a configuração global e o scrape_configs. Para verificar, acesse o status dos alvos emhttp://localhost:9090/targetsou use a interface do Prometheus para consultar métricas comoup.Crie uma regra de alerta no Prometheus que dispare quando a utilização de CPU de um nó for superior a 90% por mais de 10 minutos. Escreva a regra em YAML.
✓ Resposta:groups: - name: cpu rules: - alert: HighCPUUsage expr: 100 - (avg(rate(node_cpu_seconds_total{mode="idle"}[5m])) * 100) > 90 for: 10m labels: severity: warning annotations: summary: "High CPU usage" description: "CPU usage is above 90% for more than 10 minutes."Escreva uma consulta LogQL para buscar logs de uma aplicação que contenham a palavra "timeout" e que sejam do nível "ERROR".
✓ Resposta:{job="app"} |= "ERROR" |= "timeout"No Grafana, crie um painel que mostre a taxa de erros (erros por segundo) de uma aplicação. Escreva a expressão PromQL correspondente.
✓ Resposta: A expressão seria algo comosum(rate(http_requests_total{status=~"5.."}[5m]))ousum(rate(app_errors_total[5m])), dependendo das métricas expostas.Descreva como você configuraria o Alertmanager para enviar alertas para um canal do Slack. Inclua um exemplo de configuração.
✓ Resposta:receivers: - name: 'slack' slack_configs: - channel: '#alerts' api_url: 'https://hooks.slack.com/services/...' send_resolved: true route: receiver: 'slack'
Boas Práticas e Observações Finais
Ao construir sua stack de observabilidade, lembre-se de começar com métricas básicas e logs essenciais, depois evolua conforme necessário. Documente suas configurações e mantenha os dashboards simples e acionáveis. Teste seus alertas regularmente para garantir que funcionem. Além disso, considere a escalabilidade da stack: use o Thanos para Prometheus em múltiplos clusters, ou o Grafana Cloud para gerenciar tudo. A observabilidade é um processo contínuo de melhoria.
Continue lendo
Mais artigos de DevOps para seguir daqui.
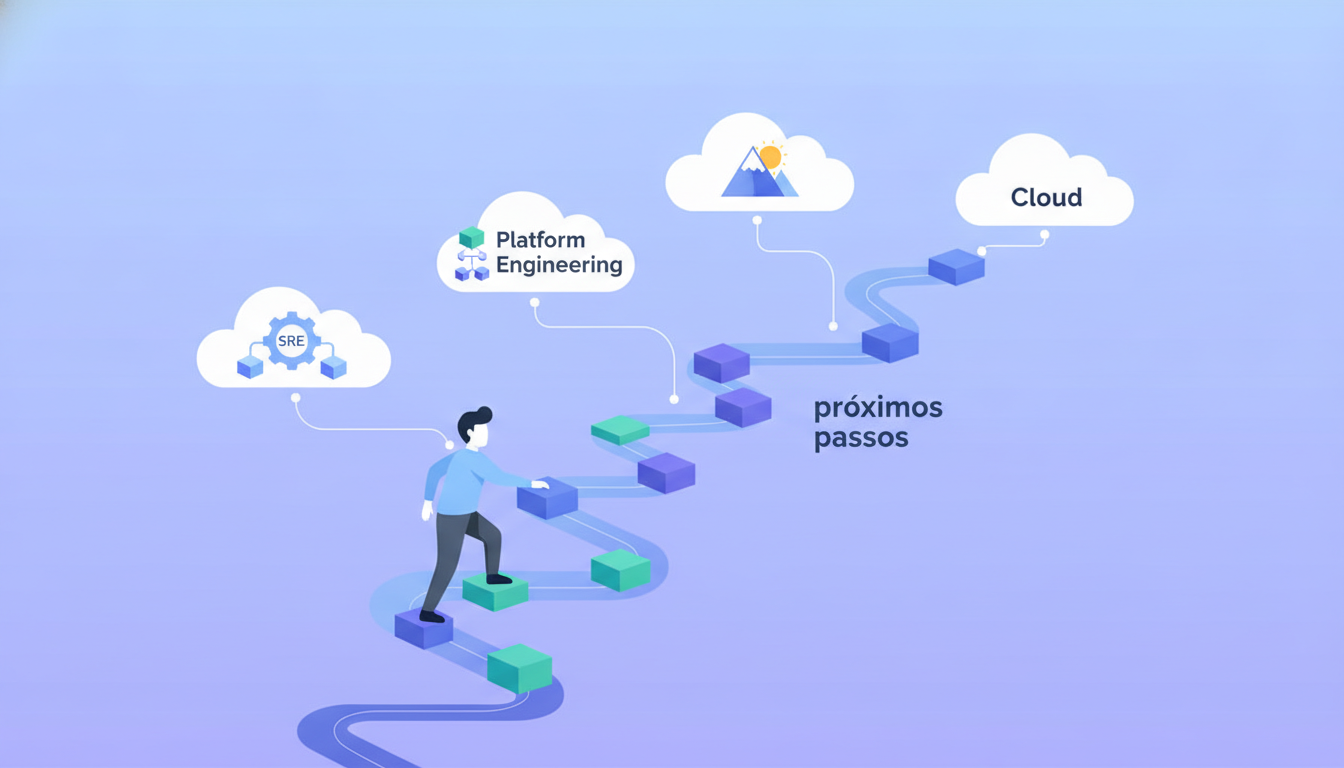
Roadmap: próximos passos em DevOps
Esta aula final consolida o aprendizado do curso de DevOps e traça um roadmap prático para os próximos passos, explorando especializações como SRE, Platform Engineering e Cloud, além de estratégias de aprofundamento técnico e recursos contínuos de aprendizado.
Lido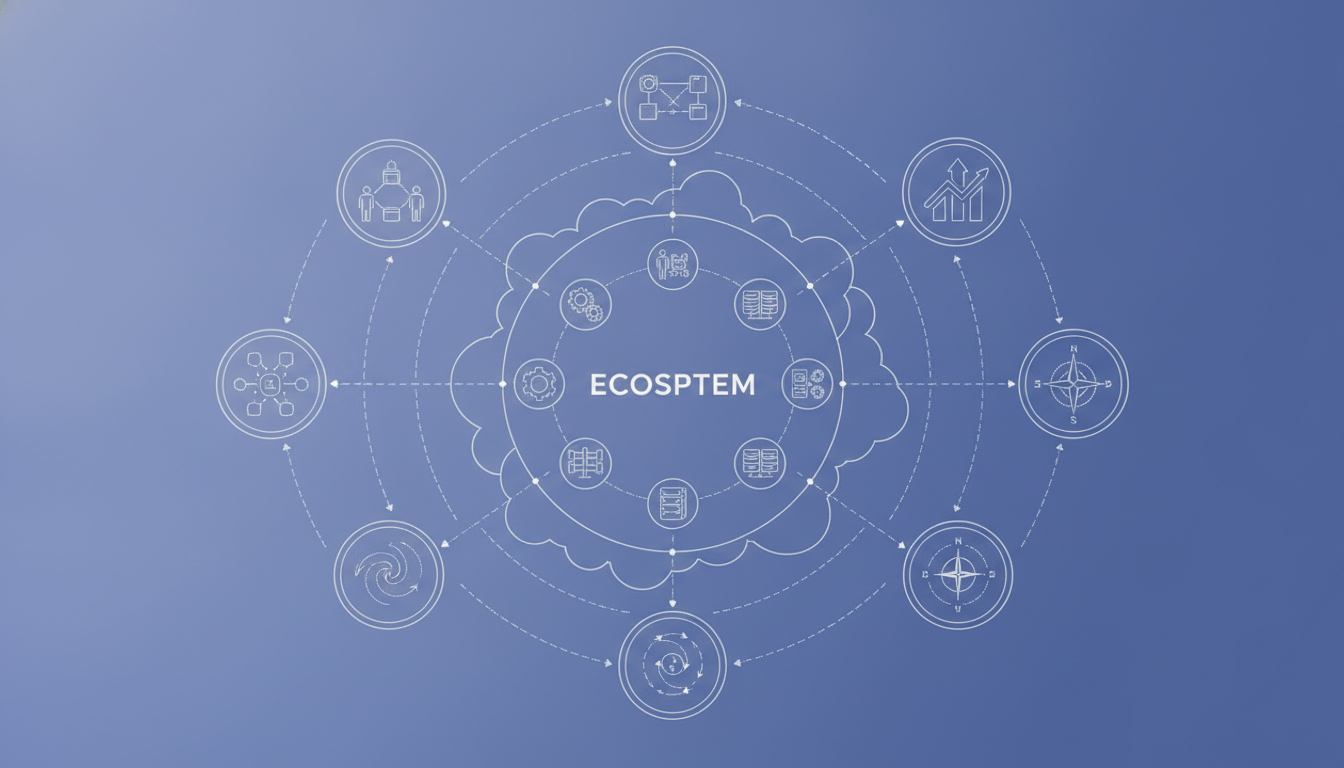
O ecossistema DevOps
Esta aula explora o ecossistema DevOps, incluindo o Cloud Native Landscape, a importância da comunidade, as tendências atuais e como se manter atualizado. O aluno compreenderá a vastidão do cenário de ferramentas e práticas, além de estratégias para acompanhar a evolução contínua da área.
Lido
Projeto: provisionar infraestrutura com IaC
Nesta aula, você aprenderá a provisionar infraestrutura como código (IaC) na prática, abordando definição de recursos, gerenciamento de estado, ambientes e versionamento. O foco é aplicar conceitos com exemplos em bash e ferramentas como Terraform, garantindo boas práticas de DevOps.
Lido