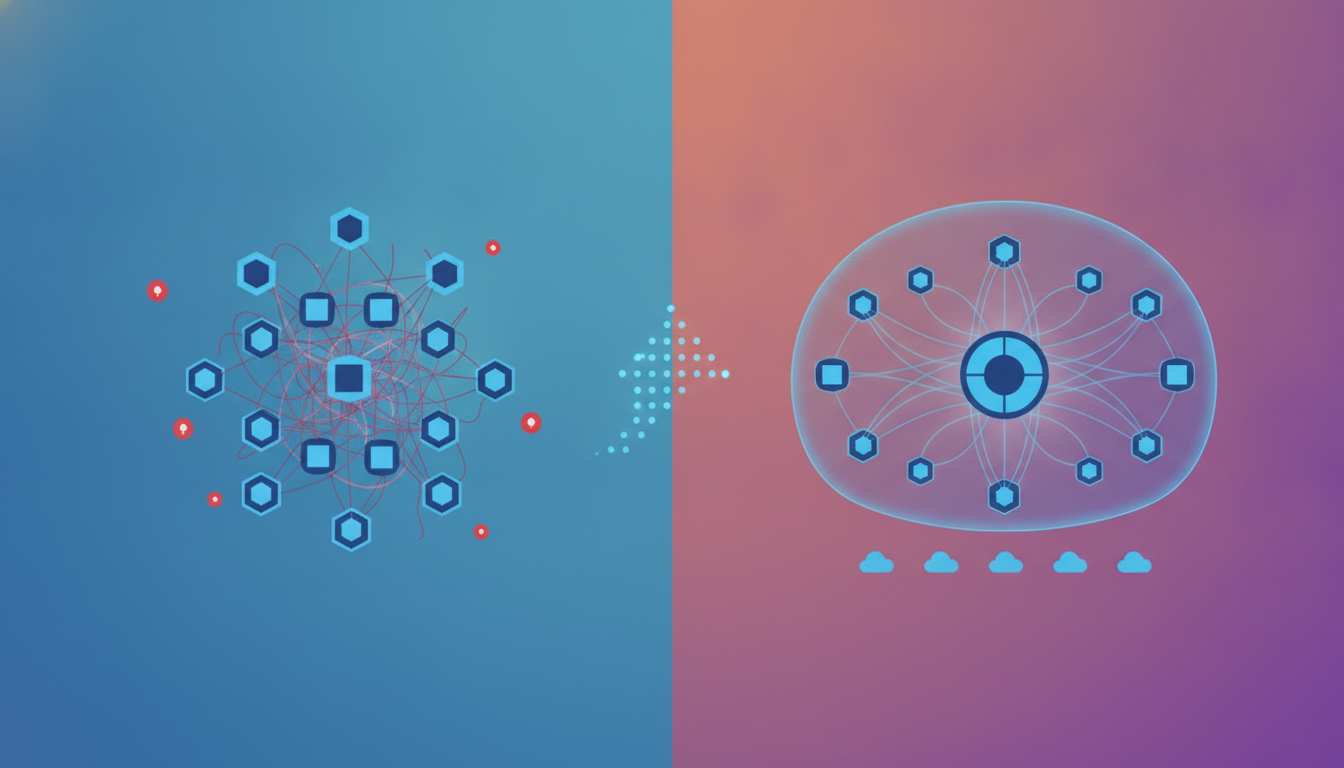
Service mesh (visão geral)
LidoEsta aula apresenta uma visão geral sobre service mesh, explicando o que é, quais problemas resolve, o panorama das principais ferramentas (Istio e Linkerd), quando vale a pena adotar e os desafios de complexidade envolvidos. O conteúdo é prático, com exemplos de arquitetura e boas práticas.
Em um ambiente de microsserviços, a comunicação entre serviços é um dos pontos mais críticos e desafiadores. Conforme a arquitetura cresce, problemas como descoberta de serviços, balanceamento de carga, autenticação mútua, observabilidade e controle de tráfego se tornam complexos de gerenciar diretamente no código de cada aplicação. É nesse contexto que surge o service mesh, uma camada de infraestrutura dedicada a lidar com a comunicação entre serviços, oferecendo uma série de recursos de forma transparente para as aplicações.
Nesta aula, vamos explorar os conceitos fundamentais de service mesh, entender o que ele resolve, comparar as principais ferramentas (Istio e Linkerd), discutir quando vale a pena adotar essa tecnologia e analisar os custos de complexidade envolvidos. Ao final, você terá uma visão clara para decidir se e como aplicar service mesh em seus projetos.
O que resolve
O service mesh resolve uma série de problemas recorrentes na comunicação entre microsserviços, que normalmente seriam implementados em cada serviço individualmente ou de forma ad-hoc. Esses problemas incluem:
- Descoberta de serviços: Em um ambiente dinâmico, os serviços precisam encontrar uns aos outros. O service mesh integra-se a mecanismos de descoberta (como Kubernetes DNS) e fornece abstrações para localizar instâncias disponíveis.
- Balanceamento de carga: Distribui o tráfego entre as instâncias de um serviço de forma eficiente, com algoritmos configuráveis (round-robin, least-request, etc.).
- Resiliência: Implementa padrões como timeouts, retries, circuit breakers e failover, aumentando a tolerância a falhas sem alterar o código da aplicação.
- Segurança: Oferece autenticação mútua (mTLS) entre serviços, criptografia de tráfego e políticas de autorização, centralizando a segurança na camada de infraestrutura.
- Observabilidade: Gera métricas, logs e traces distribuídos para cada requisição, permitindo monitorar a saúde e o desempenho da malha de serviços.
- Controle de tráfego: Permite roteamento avançado, como canary releases, blue/green deployments e mirroring, com base em regras dinâmicas.
Sem um service mesh, essas funcionalidades precisariam ser implementadas em cada serviço, resultando em duplicação de código, inconsistências e maior carga de manutenção. Com o service mesh, elas são abstraídas para uma camada de proxy, que intercepta todo o tráfego de entrada e saída do serviço.
Um exemplo típico: em uma aplicação com múltiplos microsserviços, você deseja aplicar políticas de retry e timeout para chamadas HTTP. Sem service mesh, você precisaria configurar isso em cada cliente HTTP de cada serviço. Com o service mesh, você define uma política centralizada que se aplica a todas as comunicações, sem tocar no código.
O service mesh também facilita a implementação de estratégias de deployment mais seguras, como canary releases, onde uma pequena porcentagem do tráfego é direcionada para a nova versão, e você pode monitorar o comportamento antes de liberar para todos.
Istio/Linkerd (panorama)
Existem várias implementações de service mesh, mas as duas mais populares e maduras são o Istio e o Linkerd. Vamos compará-las em termos de arquitetura, recursos e casos de uso.
Istio
O Istio é um service mesh completo e extensível, que se destaca por sua riqueza de recursos e flexibilidade. Ele é baseado em uma arquitetura com dois componentes principais: o plano de dados (data plane) e o plano de controle (control plane).
- Plano de dados: Composto por proxies sidecar (geralmente Envoy) que são injetados em cada pod. Esses proxies interceptam todo o tráfego de rede e aplicam as políticas definidas.
- Plano de controle: Gerencia a configuração e distribui as políticas para os proxies. Inclui componentes como Istiod, que combina funções de descoberta de serviços, certificados e configuração.
O Istio oferece recursos avançados como:
- Roteamento de tráfego com regras baseadas em peso, cabeçalhos, etc.
- Políticas de segurança com mTLS automático e autorização.
- Observabilidade integrada com a geração de métricas e traces (com suporte a Prometheus e Jaeger).
- Extensibilidade via WebAssembly (Wasm) para customização de filtros.
Por outro lado, o Istio é conhecido por ser complexo de instalar, configurar e operar. Ele introduz muitos Custom Resource Definitions (CRDs) e uma curva de aprendizado íngreme.
Linkerd
O Linkerd é um service mesh mais leve e simples, focado em ser de fácil adoção e baixa latência. Ele também usa proxies sidecar, mas implementados em Rust, o que o torna muito eficiente em termos de recursos.
- Plano de dados: Utiliza um proxy chamado
linkerd2-proxyque é injetado como sidecar. - Plano de controle: É mais enxuto, com menos componentes, o que facilita a operação.
O Linkerd oferece recursos essenciais como:
- mTLS automático entre serviços.
- Balanceamento de carga e resiliência (timeouts, retries, circuit breakers).
- Observabilidade com métricas e traces (integração com Prometheus e Jaeger).
- Políticas de segurança e autorização.
O Linkerd é frequentemente recomendado para quem busca simplicidade e performance, sem abrir mão das funcionalidades principais. Ele tem uma curva de aprendizado menor e consome menos recursos que o Istio.
A escolha entre Istio e Linkerd depende das necessidades do projeto. Se você precisa de recursos avançados de roteamento e extensibilidade, o Istio pode ser mais adequado. Se valoriza simplicidade e baixa sobrecarga, o Linkerd é uma excelente opção.
Abaixo, um exemplo de como instalar o Linkerd em um cluster Kubernetes:
# Instalar a CLI do Linkerd
curl -sL https://run.linkerd.io/install | sh

# Adicionar o binário ao PATH (exemplo para Linux)
export PATH=$PATH:$HOME/.linkerd2/bin

# Verificar a instalação
linkerd version

# Instalar o Linkerd no cluster
linkerd install | kubectl apply -f -

# Verificar se a instalação foi bem-sucedida
linkerd check
Já o Istio pode ser instalado com istioctl, mas requer mais passos de configuração. A escolha da ferramenta deve ser baseada em requisitos específicos e na capacidade da equipe de operá-la.
Quando vale a pena
Adotar um service mesh não é uma decisão trivial. Ele traz benefícios significativos, mas também introduz complexidade operacional. Aqui estão alguns cenários em que vale a pena considerar:
- Muitos microsserviços: Quando você tem um grande número de serviços (dezenas ou centenas), a comunicação entre eles se torna complexa. O service mesh centraliza o gerenciamento do tráfego e da segurança.
- Comunicação entre equipes: Se múltiplas equipes desenvolvem serviços independentes, o service mesh oferece um padrão comum para políticas de rede, reduzindo a duplicação de esforços.
- Requisitos de segurança rigorosos: O mTLS automático e a autorização centralizada são valiosos em ambientes regulados ou com alta exigência de segurança.
- Estratégias de deployment avançadas: Se você precisa de canary releases, blue/green deployments ou controle fino de tráfego, o service mesh facilita essas implementações.
- Observabilidade unificada: O service mesh fornece métricas e traces consistentes para todas as comunicações, melhorando o monitoramento e a depuração.
Por outro lado, em cenários simples, com poucos serviços e baixa complexidade, o service mesh pode ser um exagero. Nesses casos, os recursos oferecidos podem ser implementados com bibliotecas de código ou com funcionalidades nativas do Kubernetes (como Ingress e Network Policies).
Um exemplo prático: uma startup com 5 microsserviços e um time pequeno pode não se beneficiar imediatamente de um service mesh, pois a sobrecarga operacional pode superar os ganhos. Conforme a arquitetura cresce para 50 serviços e duas equipes, o service mesh passa a fazer mais sentido.
É importante avaliar o custo-benefício antes de adotar. O service mesh deve ser visto como uma ferramenta de infraestrutura que resolve problemas de comunicação de forma padronizada, mas que exige investimento em aprendizado e operação.
Complexidade
A complexidade é um dos principais desafios na adoção de service mesh. Ela se manifesta em vários aspectos:
- Instalação e configuração: Ferramentas como Istio têm muitos componentes e CRDs, o que torna a instalação e a configuração iniciais demoradas e sujeitas a erros.
- Operação: A malha de serviços precisa ser monitorada, atualizada e depurada. Os proxies sidecar adicionam um ponto extra de falha e exigem gerenciamento de recursos.
- Depuração: Quando algo dá errado, a camada extra de abstração pode dificultar a identificação da causa raiz. É necessário entender os componentes do service mesh para diagnosticar problemas.
- Performance: Embora os proxies sejam otimizados, eles adicionam latência a cada requisição. Em sistemas com altíssima exigência de performance, isso pode ser um problema.
- Curva de aprendizado: As equipes precisam aprender os conceitos e a operação do service mesh, o que exige tempo e treinamento.
Para mitigar a complexidade, algumas boas práticas incluem:
- Começar com um piloto em um serviço não crítico.
- Utilizar ferramentas de automação e GitOps para gerenciar a configuração.
- Adotar uma ferramenta mais simples (como Linkerd) se os requisitos não exigirem todos os recursos do Istio.
- Investir em observabilidade da própria malha (métricas do proxy, logs, etc.).
- Documentar a arquitetura e os fluxos de comunicação.
A complexidade também afeta o custo operacional. É preciso considerar o consumo de CPU e memória dos proxies, bem como o esforço de manutenção contínua. Em ambientes com muitos namespaces e serviços, a malha pode se tornar um sistema distribuído complexo de gerenciar.
Um exemplo de configuração que aumenta a complexidade é a definição de políticas de autorização no Istio, que envolve múltiplos CRDs e regras:
# Exemplo de política de autorização no Istio (YAML)
apiVersion: security.istio.io/v1beta1
kind: AuthorizationPolicy
metadata:
  name: my-policy
  namespace: default
spec:
  selector:
    matchLabels:
      app: my-service
  action: ALLOW
  rules:
  - from:
    - source:
        principals: ["cluster.local/ns/default/sa/my-client"]
    to:
    - operation:
        methods: ["GET"]
Esse tipo de configuração, embora poderoso, exige um bom entendimento do modelo de segurança do Istio. Se a equipe não estiver familiarizada, pode levar a erros de configuração que afetam a comunicação entre serviços.
Boas práticas e observações finais
Adotar service mesh requer planejamento e um entendimento claro dos trade-offs. Algumas recomendações finais:
- Comece pequeno: Implemente o service mesh em um ambiente de desenvolvimento ou em um serviço específico antes de expandir para todo o cluster.
- Automatize a configuração: Use ferramentas de IaC e GitOps para versionar e revisar as mudanças na malha.
- Monitore a malha: Acompanhe as métricas dos proxies e do plano de controle para detectar problemas de performance ou configuração.
- Documente: Mantenha uma documentação clara sobre a arquitetura de comunicação e as políticas aplicadas.
- Revise periodicamente: Avalie se o service mesh ainda é necessário e se os recursos estão sendo utilizados de forma eficiente.
Em resumo, service mesh é uma ferramenta poderosa para gerenciar a comunicação em microsserviços, mas deve ser adotada com critério. Avalie as necessidades da sua organização, os recursos da equipe e o estágio de maturidade da arquitetura antes de decidir.
Referências
- Documentação oficial do Istio
- Documentação oficial do Linkerd
- Documentação do Envoy Proxy
- Kubernetes: Serviços e rede
- Microservices.io - Padrões de microsserviços
- CNCF - Projetos de service mesh
- Red Hat - O que é service mesh
Exercícios
-
Explique, com suas palavras, o papel do plano de dados e do plano de controle em um service mesh.
✓ Resposta: O plano de dados é formado pelos proxies sidecar que interceptam o tráfego de rede entre os serviços, aplicando políticas de balanceamento, segurança, etc. O plano de controle é o conjunto de componentes que gerencia a configuração dos proxies, distribuindo políticas e coletando telemetria. No Istio, por exemplo, o Istiod é o plano de controle, enquanto o Envoy é o plano de dados. -
Qual é a principal diferença entre Istio e Linkerd em termos de simplicidade e recursos?
✓ Resposta: O Istio é mais completo e extensível, com suporte a roteamento avançado, políticas complexas e WebAssembly, porém é mais complexo de instalar e operar. O Linkerd é mais simples e leve, com foco em essenciais (mTLS, balanceamento, observabilidade), sendo mais fácil de adotar e operar, mas com menos recursos avançados. -
Em quais cenários você recomendaria o uso de service mesh? Dê dois exemplos.
✓ Resposta: 1) Uma empresa com mais de 50 microsserviços, onde várias equipes precisam de políticas consistentes de segurança e observabilidade. 2) Um sistema que exige canary releases frequentes e controle fino de tráfego, como uma plataforma de e-commerce que faz deploys contínuos. -
Cite três desafios de complexidade ao adotar um service mesh e como mitigá-los.
✓ Resposta: 1) Instalação e configuração complexas: mitigar usando ferramentas de automação, como Helm ou operadores, e começando com um piloto. 2) Operação e depuração: investir em monitoramento da malha e em treinamento da equipe. 3) Performance e consumo de recursos: escolher uma ferramenta leve (como Linkerd) e dimensionar adequadamente os proxies. -
Escreva um comando bash para instalar a CLI do Linkerd em um ambiente Linux.
✓ Resposta: O comando é:
Depois, adicione o binário ao PATH, por exemplo:curl -sL https://run.linkerd.io/install | shexport PATH=$PATH:$HOME/.linkerd2/bin
Continue lendo
Mais artigos de DevOps para seguir daqui.
Projeto: pipeline CI/CD completo
Nesta aula, você vai construir um pipeline CI/CD completo, desde o commit até o deploy automatizado, cobrindo testes, build de imagem e deploy. Vamos explorar cada etapa com exemplos práticos em bash e boas práticas para garantir entregas rápidas e seguras.
Lido
Projeto: provisionar infraestrutura com IaC
Nesta aula, você aprenderá a provisionar infraestrutura como código (IaC) na prática, abordando definição de recursos, gerenciamento de estado, ambientes e versionamento. O foco é aplicar conceitos com exemplos em bash e ferramentas como Terraform, garantindo boas práticas de DevOps.
Lido
Performance e otimização de sistemas
Nesta aula, vamos explorar os principais aspectos de performance e otimização de sistemas em DevOps, incluindo identificação de gargalos, técnicas de profiling em produção, estratégias de caching e princípios de escalabilidade. Você aprenderá como diagnosticar problemas de desempenho, aplicar soluções práticas e garantir que seus sistemas operem de forma eficiente.
Lido