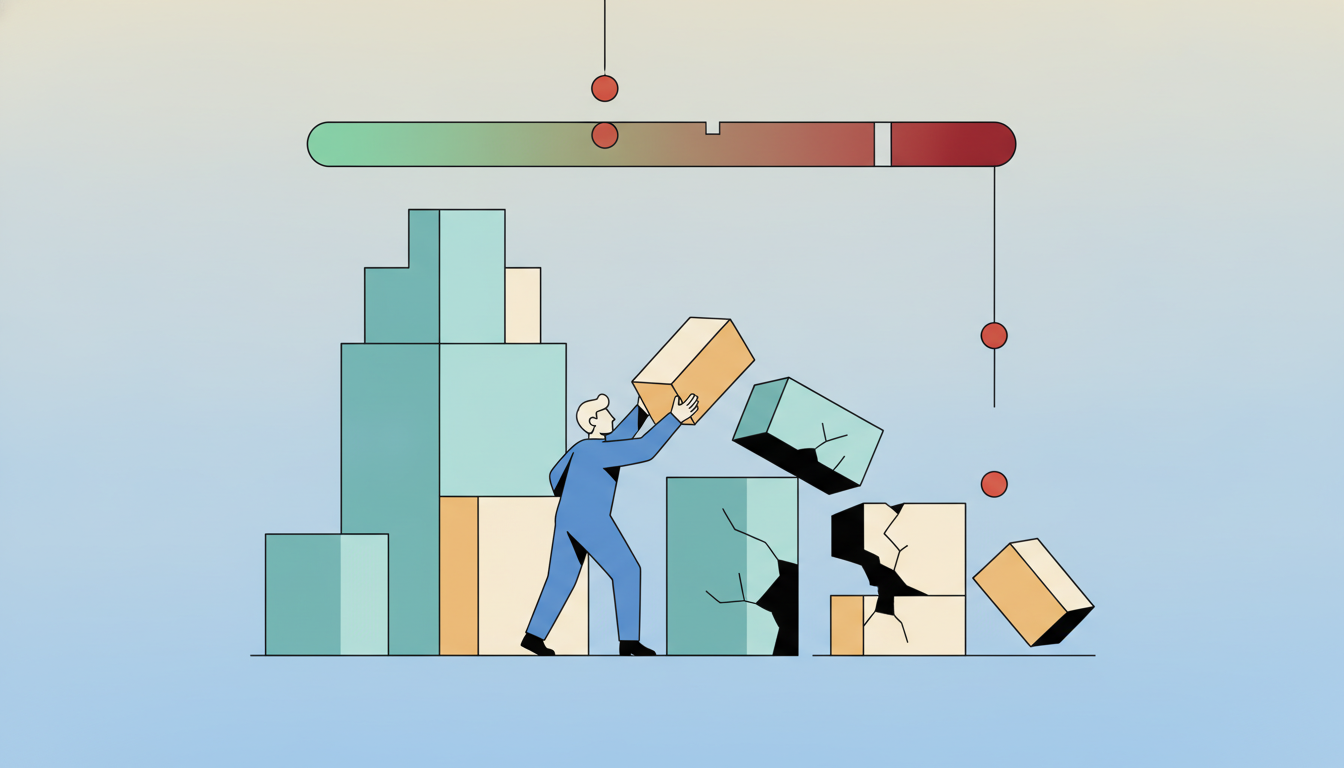
Error budgets na prática
LidoNesta aula, exploramos o conceito de error budgets no contexto de SRE e DevOps, entendendo como eles equilibram velocidade de desenvolvimento e estabilidade do sistema. Discutimos sua definição, como tomar decisões baseadas neles e exemplos práticos de implementação.
Error budgets são uma prática fundamental em SRE (Site Reliability Engineering) e DevOps, que estabelecem um limite aceitável de falhas para um serviço, equilibrando a necessidade de inovação com a estabilidade operacional. Originados do livro 'Site Reliability Engineering' do Google, os error budgets transformam a relação entre equipes de desenvolvimento e operações, promovendo uma cultura de confiança e responsabilidade compartilhada.
Nesta aula, vamos aprofundar como os error budgets funcionam na prática, desde sua definição até a tomada de decisões baseada neles, com exemplos concretos de aplicação em cenários reais.
O que são
Um error budget é a quantidade máxima de falhas que um sistema pode ter em um determinado período, sem violar o SLO (Service Level Objective) definido. Em outras palavras, é a diferença entre o SLO e 100% de disponibilidade. Por exemplo, se um serviço define um SLO de 99,9% de disponibilidade mensal, o error budget é de 0,1%, o que equivale a aproximadamente 43 minutos de indisponibilidade no mês.
O error budget é calculado com base no SLO, que por sua vez é definido a partir do SLA (Service Level Agreement) e das expectativas dos usuários. Ele serve como uma medida objetiva de quanto risco é aceitável para o serviço, permitindo que as equipes tomem decisões informadas sobre lançamentos de novas funcionalidades, mudanças de infraestrutura e outras ações que possam impactar a confiabilidade.
Na prática, o error budget é monitorado continuamente através de métricas de disponibilidade, latência e erros. Quando o budget é consumido, a equipe deve priorizar a estabilidade, reduzindo ou pausando lançamentos de novas funcionalidades até que o budget seja reabastecido (no próximo período).
# Exemplo de cálculo de error budget para um SLO de 99,9% mensal
# Disponibilidade alvo: 99,9%
# Error budget: 100% - 99,9% = 0,1%
# Tempo de indisponibilidade permitido por mês (30 dias):
# 30 dias * 24 horas * 60 minutos * 0,001 = 43,2 minutos

# Comando para calcular em bash (ilustrativo)
echo "Error budget em minutos: $((30 * 24 * 60 * 1000 / 1000))"
Equilíbrio entre velocidade e estabilidade
Um dos principais desafios em DevOps é conciliar a necessidade de entregar novas funcionalidades rapidamente com a manutenção da estabilidade do sistema. Os error budgets oferecem uma estrutura para gerenciar esse trade-off de forma explícita e baseada em dados.
Quando o error budget está alto (ou seja, o sistema está operando bem dentro dos limites), a equipe pode acelerar o ritmo de lançamentos, experimentar novas ideias e assumir mais riscos. Por outro lado, quando o budget está baixo ou esgotado, a prioridade deve ser a correção de problemas e a restauração da confiabilidade, mesmo que isso signifique adiar novas entregas.
Essa abordagem cria um ciclo virtuoso: a equipe de desenvolvimento tem autonomia para inovar quando há margem, e a equipe de operações tem autoridade para interromper lançamentos quando o risco é alto. Isso reduz conflitos e promove uma cultura de responsabilidade compartilhada pelo desempenho do serviço.
Além disso, os error budgets incentivam a automação de testes e monitoramento, pois é essencial ter métricas precisas para saber onde estamos em relação ao budget. Ferramentas como Prometheus, Grafana e Datadog são comumente usadas para rastrear esses dados em tempo real.
Decisões
Os error budgets não são apenas métricas passivas; eles devem orientar decisões ativas no ciclo de vida do serviço. Algumas decisões típicas incluem:
- Lançamento de novas versões: Se o error budget está confortável, a equipe pode proceder com deploys mais frequentes. Caso contrário, pode-se congelar lançamentos até que a estabilidade seja restaurada.
- Investimento em confiabilidade: Quando o budget é frequentemente esgotado, é um sinal de que o serviço precisa de mais investimentos em arquitetura, testes, ou infraestrutura para melhorar sua resiliência.
- Priorização de bugs: Bugs que impactam diretamente o error budget devem ser tratados com prioridade máxima, enquanto outros podem ser agendados normalmente.
- Capacidade de inovação: Equipes com um error budget saudável podem alocar tempo para experimentos e melhorias de produto, enquanto aquelas com budget esgotado devem focar em estabilidade.
Para tomar essas decisões, é crucial ter um processo claro e comunicação transparente entre as equipes. Muitas organizações realizam reuniões periódicas para revisar o status do error budget e decidir as próximas ações.
Um exemplo prático: se um serviço de pagamento online tem um SLO de 99,95% e o error budget está 50% consumido no meio do mês, a equipe pode decidir adiar um lançamento planejado para a próxima semana, a fim de evitar riscos adicionais.
Exemplos
Vamos considerar dois cenários para ilustrar a aplicação de error budgets.
Cenário 1: Comércio eletrônico
Uma loja virtual define um SLO de 99,9% de disponibilidade para seu site. Em um mês de alta demanda (Black Friday), o error budget é consumido rapidamente devido a picos de tráfego. A equipe de DevOps decide pausar lançamentos de novas funcionalidades e focar em otimizações de desempenho e escalabilidade. Após o evento, o budget é reabastecido no próximo mês, e os lançamentos são retomados.
Cenário 2: API de terceiros
Uma empresa fornece uma API pública com SLO de 99,95% de disponibilidade. Durante um trimestre, o error budget é consistentemente esgotado, indicando problemas crônicos de infraestrutura. A equipe decide alocar um sprint inteiro para reestruturar o serviço, implementando melhorias como balanceamento de carga, redundância e monitoramento avançado. No trimestre seguinte, o budget fica estável, e a empresa pode retomar um ritmo normal de entregas.
Esses exemplos mostram como os error budgets orientam a tomada de decisão, promovendo um equilíbrio entre inovação e confiabilidade.
Boas práticas e observações finais
Para implementar error budgets de forma eficaz, considere:
- Defina SLOs realistas baseados em dados históricos e expectativas de negócio.
- Monitore continuamente as métricas que compõem o error budget (disponibilidade, latência, erros).
- Automatize alertas para quando o budget estiver se esgotando rapidamente.
- Estabeleça políticas claras sobre quando interromper lançamentos e como priorizar correções.
- Revise periodicamente os SLOs e error budgets para garantir que ainda fazem sentido para o negócio.
Lembre-se de que error budgets não são punitivos, mas sim uma ferramenta de colaboração para melhorar a confiabilidade e a velocidade de entrega.
Exercícios
Calcule o error budget mensal (em minutos) para um serviço com SLO de 99,99% de disponibilidade. Considere um mês de 30 dias.
✓ Resposta: O error budget é 0,01% do tempo total. Em minutos: 30 * 24 * 60 * 0,0001 = 4,32 minutos.Quais são as principais decisões que uma equipe pode tomar quando o error budget está esgotado? Dê pelo menos três exemplos.
✓ Resposta: 1) Congelar lançamentos de novas funcionalidades; 2) Priorizar correções de bugs que impactam a disponibilidade; 3) Alocar tempo para melhorias de infraestrutura e resiliência.Explique a relação entre SLA, SLO e error budget.
✓ Resposta: SLA é o acordo contratual com o cliente, SLO é o objetivo de nível de serviço que a equipe se compromete a atingir (geralmente derivado do SLA), e o error budget é a diferença entre o SLO e 100%, representando a margem de falhas aceitável.Como os error budgets influenciam a cultura de uma organização DevOps?
✓ Resposta: Eles promovem colaboração entre dev e ops, reduzem conflitos ao fornecer uma base objetiva para decisões, incentivam a automação e o monitoramento, e criam uma cultura de responsabilidade compartilhada pela confiabilidade.Cite duas ferramentas populares para monitorar métricas relacionadas a error budgets.
✓ Resposta: Prometheus e Grafana são comumente usados para monitorar disponibilidade e latência, permitindo calcular e visualizar o consumo do error budget.
Referências
Continue lendo
Mais artigos de DevOps para seguir daqui.
Site Reliability Engineering (SRE)
Esta aula apresenta o conceito de Site Reliability Engineering (SRE), sua origem no Google, os princípios fundamentais e como ele se relaciona com DevOps. O aluno aprenderá a importância da confiabilidade em sistemas de software e como aplicar práticas de SRE no dia a dia.
Lido
Serverless e FaaS
Esta aula explora o paradigma serverless e Function as a Service (FaaS), explicando o que são, quando utilizá-los, seus trade-offs e o problema dos cold starts. Inclui exemplos práticos, boas práticas e exercícios para fixação.
Lido
Alertas e on-call
Esta aula aborda a criação de alertas eficazes em DevOps, focando em alertas acionáveis, prevenção de fadiga de alertas, estratégias de escalonamento e uso de runbooks. Inclui exemplos práticos com Prometheus e Alertmanager, boas práticas e exercícios com respostas.
Lido