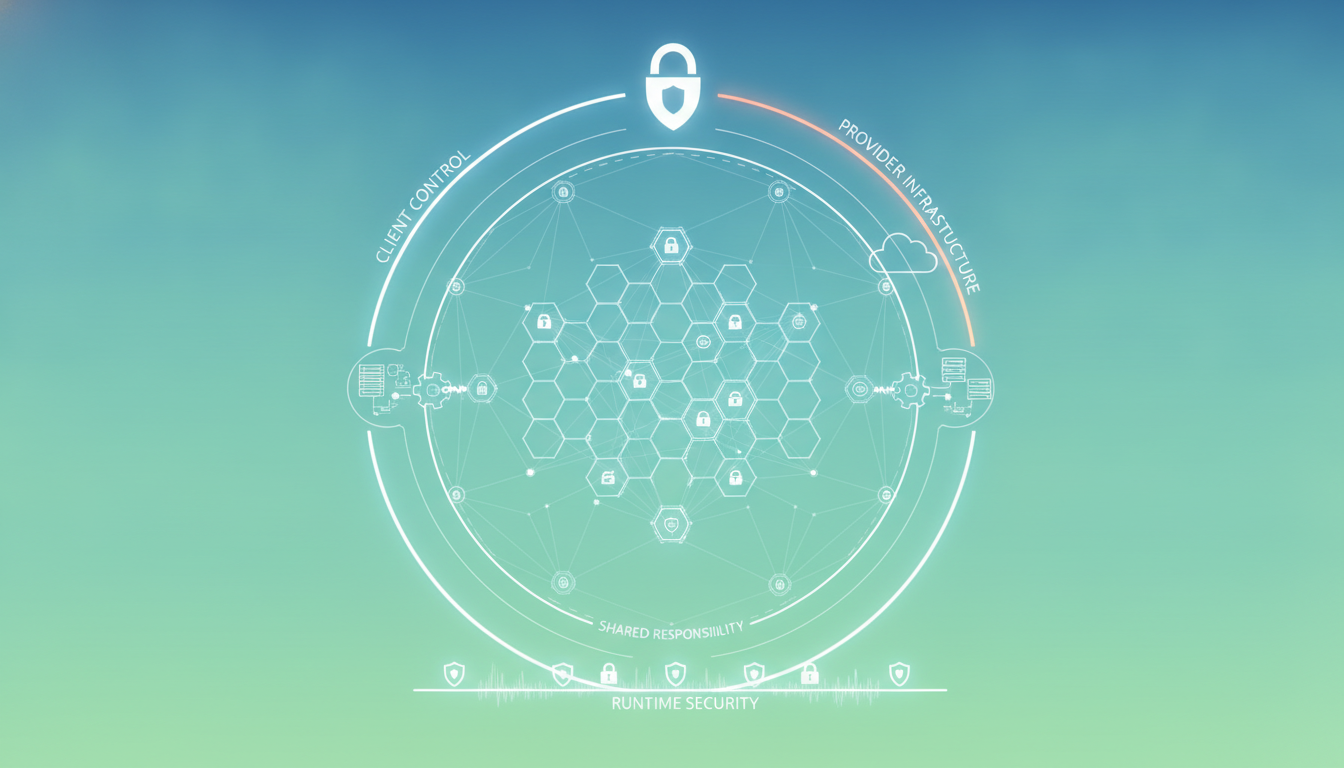
Segurança de Cloud Native
LidoEsta aula aborda os fundamentos de segurança em ambientes cloud native, incluindo service meshes, o modelo de responsabilidade compartilhada e práticas de segurança em runtime. Você aprenderá como proteger serviços distribuídos, entender as fronteiras de responsabilidade entre provedor e cliente, e implementar controles de segurança em tempo de execução.
Cloud native é uma abordagem para construir e executar aplicações que exploram os benefícios do modelo de computação em nuvem. Contêineres, orquestração (como Kubernetes), microsserviços e infraestrutura imutável são pilares desse paradigma. No entanto, essa arquitetura distribuída e dinâmica introduz novos desafios de segurança que exigem estratégias específicas. Nesta aula, vamos explorar três pilares essenciais para proteger ambientes cloud native: service meshes, o modelo de responsabilidade compartilhada e a segurança em runtime.
A segurança em cloud native não é um complemento, mas sim uma propriedade fundamental que deve ser incorporada desde o design. Diferente de ambientes tradicionais, onde a rede era o principal perímetro, em cloud native o perímetro é fluido: serviços se comunicam entre si em uma malha complexa, e a confiança deve ser estabelecida por identidade e políticas, não por endereços IP. Vamos entender como as ferramentas e práticas evoluíram para atender a essas necessidades.
Service meshes
Em uma arquitetura de microsserviços, a comunicação entre serviços é intensa e frequente. Cada serviço precisa se comunicar com outros de forma segura, autenticando e autorizando chamadas, e muitas vezes criptografando o tráfego. Implementar isso diretamente em cada serviço é trabalhoso e propenso a erros. É aí que entram os service meshes: uma camada de infraestrutura dedicada que lida com a comunicação entre serviços, oferecendo recursos como TLS mútuo (mTLS), políticas de autorização, observabilidade e resiliência, sem exigir mudanças no código dos serviços.
Um service mesh é tipicamente composto por um plano de dados e um plano de controle. O plano de dados é formado por proxies sidecar que são injetados ao lado de cada instância de serviço. Todo o tráfego de entrada e saída do serviço passa pelo proxy, que aplica as políticas e criptografia. O plano de controle gerencia as configurações e distribui certificados e políticas para os proxies. Exemplos populares incluem Istio, Linkerd e Consul Connect.
Um dos principais benefícios de segurança de um service mesh é o mTLS automático. Com o mTLS, cada serviço apresenta um certificado que identifica sua identidade (geralmente baseado em service account). Isso impede ataques man-in-the-middle e garante que apenas serviços autenticados possam se comunicar. Além disso, o mesh permite definir políticas de autorização granulares, como "o serviço A só pode chamar o endpoint GET do serviço B", usando atributos como identidade, método HTTP e path.
Exemplo de configuração de política de autorização no Istio (usando uma definição de recurso do Kubernetes):
apiVersion: security.istio.io/v1
kind: AuthorizationPolicy
metadata:
  name: allow-get-only
spec:
  selector:
    matchLabels:
      app: payments
  action: ALLOW
  rules:
  - to:
    - operation:
        methods: ["GET"]
Nesse exemplo, a política permite apenas requisições GET para o serviço 'payments'. Qualquer outro método será negado. Isso reduz a superfície de ataque e impede ações não autorizadas.
Além da autorização, o mesh oferece observabilidade de segurança, gerando logs de acesso e métricas que podem ser usados para detecção de anomalias. Por exemplo, você pode detectar um aumento súbito de tráfego para um serviço, que pode indicar um ataque de força bruta ou um vazamento de dados.
É importante lembrar que o service mesh não é uma bala de prata: ele protege o tráfego entre serviços, mas não protege contra vulnerabilidades no código da aplicação ou contra ataques que exploram outras superfícies, como APIs públicas. Ele deve ser parte de uma estratégia de segurança em camadas.
Shared responsibility
No cloud computing, a segurança é uma responsabilidade compartilhada entre o provedor de nuvem e o cliente. O provedor é responsável pela segurança da nuvem (security of the cloud), ou seja, pela infraestrutura física, rede, hipervisores e serviços gerenciados. O cliente é responsável pela segurança na nuvem (security in the cloud), ou seja, pela configuração de seus recursos, dados, identidades e aplicações. Esse modelo varia conforme o tipo de serviço: IaaS, PaaS ou SaaS.
Em cloud native, essa divisão fica mais complexa. Por exemplo, em um cluster Kubernetes gerenciado (como EKS, AKS ou GKE), o provedor cuida do plano de controle (API server, etcd) e da infraestrutura dos nós, mas você é responsável por configurar os nós de trabalho (worker nodes), as políticas de rede, os controles de acesso (RBAC), as imagens dos contêineres e a segurança do runtime. Além disso, você precisa garantir que seus contêineres sejam executados com privilégios mínimos e que as imagens sejam escaneadas em busca de vulnerabilidades.
Entender o modelo de responsabilidade compartilhada é crucial para evitar lacunas de segurança. Muitas organizações assumem que, por estarem na nuvem, a segurança é inteiramente do provedor, o que é um erro perigoso. Por outro lado, provedores oferecem ferramentas de segurança (como AWS Security Hub, Azure Defender, Google Security Command Center) que ajudam a monitorar e corrigir problemas, mas a responsabilidade final de usar essas ferramentas e agir sobre os alertas é do cliente.
Vamos detalhar as responsabilidades comuns em um ambiente cloud native com Kubernetes:
- Provedor de nuvem: Segurança física dos data centers, infraestrutura de rede, hipervisor, e o plano de controle do Kubernetes gerenciado (se aplicável).
- Cliente: Configuração do cluster (como RBAC, políticas de rede, limites de recursos), segurança dos nós (patch de SO, hardening, isolamento), segurança dos contêineres (imagens, runtime), segurança da aplicação (código, dependências), e gerenciamento de segredos (credenciais, chaves).
Para ilustrar, em um cluster Kubernetes autogerenciado (self-managed), você é responsável por tudo, desde o sistema operacional dos nós até o plano de controle. Já em um serviço gerenciado, o provedor cuida do plano de controle, mas você ainda precisa configurar os nós e os recursos. Sempre consulte a documentação do seu provedor para entender exatamente o que é responsabilidade de cada parte.
Uma boa prática é criar uma matriz de responsabilidades específica para o seu ambiente, listando cada componente e quem é responsável por sua segurança. Isso ajuda a evitar suposições e garante que todas as áreas sejam cobertas.
Runtime
Segurança em runtime refere-se às medidas de proteção aplicadas enquanto os contêineres e aplicações estão em execução. Isso inclui detecção de ameaças, prevenção de comportamentos maliciosos, e resposta a incidentes em tempo real. Diferente da segurança de imagem (que analisa o código estático), a segurança em runtime lida com o comportamento dinâmico: o que o processo está fazendo, quais chamadas de sistema está realizando, e se está tentando acessar recursos não autorizados.
Em cloud native, os contêineres são efêmeros e escalam horizontalmente, o que torna a segurança em runtime desafiadora. Soluções tradicionais de segurança baseadas em agentes podem não funcionar bem em ambientes com muitos contêineres que sobem e descem rapidamente. Por isso, surgiram ferramentas específicas, como Falco, Aqua Security, Sysdig Secure e Cilium, que se integram ao orquestrador e monitoram o runtime de forma nativa.
Essas ferramentas geralmente usam hooks no kernel (como eBPF) para observar chamadas de sistema e eventos do kernel em cada contêiner. Elas podem detectar comportamentos suspeitos, como:
- Execução de processos não autorizados (ex.: shell em um contêiner que normalmente não o usa).
- Tentativas de leitura de arquivos sensíveis (ex.: /etc/shadow).
- Conexões de rede para endereços IP maliciosos ou não permitidos.
- Escalonamento de privilégios (ex.: tentativa de executar com UID 0).
Exemplo de regra do Falco para detectar shell em contêiner:
- rule: Terminal shell in container
  desc: Detect a shell spawned in a container
  condition: container.id != "host" and proc.name in (bash, sh, zsh)
  output: "Shell (proc.cmdline) launched in container (container.name)"
  priority: WARNING
Essa regra gera um alerta quando um shell é executado em um contêiner, o que pode indicar uma tentativa de exploração ou atividade maliciosa.
Além da detecção, é importante ter políticas de prevenção que bloqueiem ações inseguras. Por exemplo, no Kubernetes, você pode usar Pod Security Policies (PSP) ou Pod Security Admission (PSA) para restringir privilégios, como impedir que contêineres rodem como root ou que montem diretórios do host. Ferramentas de runtime podem aplicar essas políticas em tempo real, matando processos ou bloqueando chamadas de sistema que violem as regras.
Outro aspecto crucial é a resposta a incidentes. Em cloud native, a resposta deve ser automatizada e rápida. Por exemplo, se um contêiner for comprometido, você pode configurar o sistema para matar o contêiner e iniciar um novo, ou para isolar o nó. Isso reduz o tempo de exposição. Ferramentas como Falco podem ser integradas a sistemas de alerta (Prometheus, Slack) e a automação (como Argo Rollouts) para acionar respostas.
Lembre-se de que a segurança em runtime complementa outras camadas: você deve ter imagens seguras, configurar RBAC corretamente, usar service mesh para comunicação segura, e monitorar o runtime para detectar o que passou pelas outras defesas. É a última linha de defesa.
Boas práticas e observações finais
Para concluir, aqui estão algumas boas práticas que resumem os conceitos desta aula:
- Use um service mesh para gerenciar comunicações entre serviços, habilitando mTLS e políticas de autorização. Isso centraliza a segurança de rede e reduz a complexidade.
- Entenda claramente o modelo de responsabilidade compartilhada do seu provedor e documente suas responsabilidades. Nunca presuma que o provedor cuida de tudo.
- Implemente segurança em runtime com ferramentas como Falco ou Sysdig. Configure regras para detectar comportamentos anômalos e responda automaticamente quando possível.
- Mantenha as imagens dos contêineres atualizadas e escaneadas, mas não confie apenas nisso: o runtime pode pegar o que a análise estática não viu.
- Adote o princípio do menor privilégio em todos os níveis: RBAC no Kubernetes, políticas de rede, permissões de serviço, e capacidades do kernel.
Essas práticas ajudarão a construir uma postura de segurança robusta em seus ambientes cloud native, reduzindo riscos e aumentando a resiliência.
Exercícios
- Explique o papel do service mesh na segurança de comunicação entre microsserviços. Cite pelo menos dois benefícios de segurança que ele oferece e como eles são implementados.
- Descreva o modelo de responsabilidade compartilhada em um ambiente Kubernetes gerenciado (por exemplo, EKS). Liste três responsabilidades do provedor e três do cliente.
- Diferencie segurança de imagem de contêiner e segurança em runtime. Dê um exemplo de uma ameaça que só pode ser detectada em runtime.
- No contexto de service mesh, explique o que é mTLS e por que ele é importante. Como o service mesh facilita a implementação de mTLS?
- Considere um cenário em que um contêiner é comprometido e um atacante tenta executar comandos shell. Qual ferramenta de runtime você usaria para detectar isso e qual regra você criaria? Descreva a regra em alto nível.
Referências
Continue lendo
Mais artigos de Segurança da Informação para seguir daqui.
Segurança de Incident Simulation
Esta aula explora a simulação de incidentes de segurança, com foco em exercícios de mesa (tabletop), boas práticas para conduzi-los, lições aprendidas e métricas para avaliar a eficácia. O aluno aprenderá a planejar, executar e melhorar continuamente simulações de incidentes, fortalecendo a preparação da equipe de resposta.
Lido
Segurança de Cyber Resilience
Esta aula aborda a segurança de cyber resilience, focando em quatro pilares essenciais: recovery, redundancy, testing e preparedness. Você aprenderá a importância de cada um, como implementá-los na prática e como eles se integram para garantir que sua organização possa se recuperar rapidamente de incidentes cibernéticos.
Lido
Segurança de OWASP Juice Shop
Esta aula explora o OWASP Juice Shop, uma aplicação web deliberadamente vulnerável usada para treinar segurança ofensiva e defensiva. Você aprenderá sobre os desafios (labs), como conduzir walkthroughs, estratégias de remediação e práticas seguras de desenvolvimento, com exemplos práticos e exercícios.
Lido