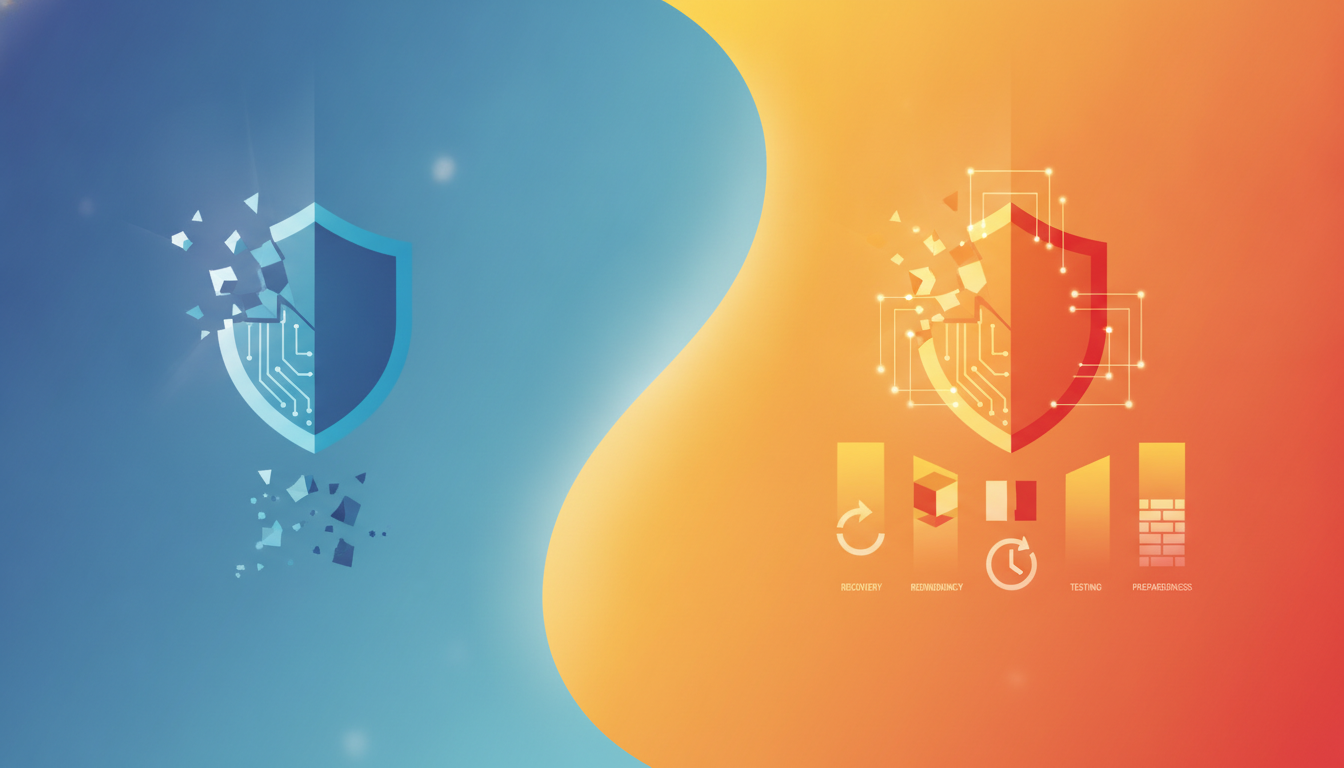
Segurança de Cyber Resilience
LidoEsta aula aborda a segurança de cyber resilience, focando em quatro pilares essenciais: recovery, redundancy, testing e preparedness. Você aprenderá a importância de cada um, como implementá-los na prática e como eles se integram para garantir que sua organização possa se recuperar rapidamente de incidentes cibernéticos.
A segurança de cyber resilience é um conceito abrangente que vai além da prevenção de ataques cibernéticos. Trata-se da capacidade de uma organização de se preparar, responder e se recuperar de incidentes, garantindo a continuidade dos negócios e a minimização de danos. Nesta aula, vamos explorar os quatro pilares fundamentais da cyber resilience: recovery, redundancy, testing e preparedness. Cada um desses pilares desempenha um papel crucial na construção de uma postura de segurança robusta, capaz de resistir e se adaptar a ameaças em constante evolução.
A cyber resilience não é um destino, mas um processo contínuo de melhoria. Ela exige planejamento cuidadoso, investimento em tecnologias e treinamento, e uma cultura organizacional que valorize a segurança. Ao dominar esses pilares, você estará apto a desenvolver estratégias eficazes para proteger sua organização e garantir sua sobrevivência diante de adversidades digitais.
Recovery
Recovery, ou recuperação, é o processo de restaurar sistemas, dados e operações após um incidente cibernético. O objetivo é retornar ao estado normal de funcionamento o mais rápido possível, minimizando perdas e impactos. A recuperação envolve não apenas a restauração de backups, mas também a análise pós-incidente para identificar causas e implementar melhorias.
Um plano de recuperação eficaz deve incluir a definição de objetivos de tempo de recuperação (RTO) e objetivos de ponto de recuperação (RPO). O RTO indica o tempo máximo aceitável para restaurar as operações, enquanto o RPO define a quantidade máxima de dados que podem ser perdidos. Esses parâmetros orientam as estratégias de backup e a escolha de tecnologias de recuperação.
Exemplo de código (simulação de restauração de backup em um script):
#!/bin/bash
# Script de restauração de backup
BACKUP_DIR="/mnt/backups"
RESTORE_DIR="/var/www"
LATEST_BACKUP=$(ls -t $BACKUP_DIR | head -n1)
echo "Restaurando backup: $LATEST_BACKUP"
cp -r $BACKUP_DIR/$LATEST_BACKUP $RESTORE_DIR
echo "Restauração concluída."
Redundancy
Redundância é a prática de ter componentes, sistemas ou dados duplicados para garantir disponibilidade e continuidade em caso de falha. Na cyber resilience, a redundância pode ser aplicada em diversos níveis: hardware, rede, dados e até mesmo equipes. O objetivo é eliminar pontos únicos de falha.
Existem diferentes tipos de redundância, como a redundância ativa (onde múltiplos componentes operam simultaneamente) e a redundância passiva (onde um componente reserva assume quando o principal falha). Por exemplo, um servidor pode ter dois discos em RAID 1, espelhando os dados, ou uma organização pode manter um site de recuperação de desastres em outra localização geográfica.
Exemplo de configuração de redundância em um arquivo de infraestrutura como código (exemplo conceitual):
# Exemplo de configuração de redundância (YAML)
servers:
  - name: web-primary
    region: us-east-1
  - name: web-secondary
    region: us-west-2
load_balancer:
  enable: true
  health_check: "/health"
Testing
Testar os planos de recuperação e redundância é essencial para garantir que eles funcionem quando necessário. Muitas organizações negligenciam essa etapa, o que resulta em planos que não são eficazes em situações reais. Os testes devem ser realizados regularmente e incluir simulações de incidentes, exercícios de mesa e testes de restauração.
Existem várias metodologias de teste, como o teste de recuperação de desastres (DR), que valida a capacidade de restaurar sistemas em um ambiente alternativo, e o teste de penetração, que avalia a segurança dos sistemas. Além disso, é importante testar a comunicação e a coordenação entre as equipes durante um incidente.
Um exemplo de script de teste automatizado para verificar a integridade de backups:
# Teste de integridade de backups
BACKUP_FILE="backup_2025-03-24.tar.gz"
if gzip -t $BACKUP_FILE; then
    echo "Backup íntegro."
else
    echo "Backup corrompido!"
    exit 1
fi
Preparedness
Preparedness, ou prontidão, refere-se ao estado de estar preparado para lidar com incidentes cibernéticos de forma eficaz. Isso envolve a criação de políticas, treinamento de equipes, estabelecimento de canais de comunicação e a definição de papéis e responsabilidades. A prontidão é a base para as outras três áreas.
Uma organização preparada possui um plano de resposta a incidentes documentado, realiza treinamentos regulares de conscientização em segurança e mantém uma equipe de resposta treinada. Além disso, é fundamental manter um inventário atualizado de ativos e dependências, bem como estabelecer parcerias com entidades externas, como fornecedores de segurança e agências governamentais.
Exemplo de um checklist de prontidão (texto):
- Plano de resposta a incidentes aprovado e divulgado.
- Equipe de resposta designada e treinada.
- Canais de comunicação de emergência estabelecidos.
- Backups verificados e armazenados em local seguro.
- Contatos de fornecedores e autoridades atualizados.
- Treinamento de conscientização realizado nos últimos 6 meses.
Boas Práticas e Observações Finais
Integrar recovery, redundancy, testing e preparedness em uma estratégia coesa é um desafio, mas algumas boas práticas podem ajudar. Automatize processos de backup e restauração sempre que possível, monitore continuamente a eficácia dos planos e promova uma cultura de segurança em que todos os colaboradores entendam seu papel na resiliência cibernética.
Lembre-se de que a cyber resilience é um ciclo contínuo: planejar, implementar, testar, aprender e melhorar. Mantenha-se atualizado sobre novas ameaças e tecnologias, e revise seus planos regularmente para garantir que estejam alinhados com o cenário atual. A resiliência não é um produto final, mas uma jornada constante de aprimoramento.
Referências
- NIST Cybersecurity Framework
- NIST SP 800-34 Rev. 1: Contingency Planning Guide for Federal Information Systems
- ISO/IEC 27001:2013 - Information security management
- Ready.gov - Business Preparedness
- CISA Cyber Resilience
- IBM: Disaster Recovery
Exercícios
-
Explique a diferença entre RTO e RPO e dê um exemplo de cada.
✓ Resposta: RTO (Recovery Time Objective) é o tempo máximo aceitável para restaurar as operações após um desastre. Por exemplo, uma empresa pode estipular que seus sistemas críticos devem estar online em até 4 horas. RPO (Recovery Point Objective) é a quantidade máxima de dados que podem ser perdidos, medida em tempo. Por exemplo, um RPO de 1 hora significa que os backups devem ser feitos pelo menos a cada hora, para que no máximo 1 hora de dados seja perdida.
-
Cite três tipos de redundância e explique como cada uma contribui para a resiliência.
✓ Resposta: 1) Redundância de hardware: ter servidores duplicados ou discos em RAID para evitar falhas físicas. 2) Redundância de rede: múltiplos caminhos de comunicação para garantir conectividade. 3) Redundância de dados: manter cópias em locais diferentes (backups) para evitar perda em caso de desastre. Cada uma assegura que um ponto único de falha não derrube todo o sistema.
-
Por que é importante testar os planos de recuperação? Dê dois exemplos de testes.
✓ Resposta: Testar garante que os planos funcionem na prática e que os envolvidos saibam como agir. Exemplos: 1) Exercício de mesa: uma simulação de incidente onde a equipe discute as ações sem executá-las de fato. 2) Teste de failover: ativar o ambiente redundante para verificar se ele assume corretamente as operações.
-
Liste cinco componentes que devem estar presentes em um plano de preparedness.
✓ Resposta: 1) Plano de resposta a incidentes documentado. 2) Equipe de resposta treinada com papéis definidos. 3) Canais de comunicação de emergência (ex.: telefones, e-mails). 4) Backups atualizados e testados. 5) Contatos de fornecedores, órgãos reguladores e autoridades.
-
Descreva um cenário onde a falta de redundância causou impactos significativos e como a redundância poderia ter evitado.
✓ Resposta: Por exemplo, uma empresa que hospeda seu site em um único servidor físico sem backup. Se o servidor sofrer uma falha de hardware, o site fica fora do ar por horas ou dias, causando perda de vendas e reputação. Com redundância, como um servidor espelho em data center diferente, o tráfego poderia ser redirecionado automaticamente, mantendo o site disponível.
Continue lendo
Mais artigos de Segurança da Informação para seguir daqui.
Segurança de Cloud Native
Esta aula aborda os fundamentos de segurança em ambientes cloud native, incluindo service meshes, o modelo de responsabilidade compartilhada e práticas de segurança em runtime. Você aprenderá como proteger serviços distribuídos, entender as fronteiras de responsabilidade entre provedor e cliente, e implementar controles de segurança em tempo de execução.
Lido
Segurança de Labs Práticos
Esta aula aborda a segurança em laboratórios práticos de hacking e testes de invasão, cobrindo desde a configuração segura do ambiente até a documentação e definição de escopo. Aprenda a montar um lab seguro, testar com ética, documentar suas ações e respeitar limites legais.
Lido
Segurança de Incident Simulation
Esta aula explora a simulação de incidentes de segurança, com foco em exercícios de mesa (tabletop), boas práticas para conduzi-los, lições aprendidas e métricas para avaliar a eficácia. O aluno aprenderá a planejar, executar e melhorar continuamente simulações de incidentes, fortalecendo a preparação da equipe de resposta.
Lido